


Guerra & Paz: «as livrarias físicas são a base da nossa operação»
A verdadeira medida do nosso sucesso encontra-se junto dos nossos clientes. A sua satisfação e o reconhecimento pelo trabalho que entregamos são o motor que nos leva a construir parcerias cada vez mais sólidas e duradouras.
É com esse espírito que inauguramos hoje uma série de artigos nascida de conversas diretas com quem confia em nós. Através de quatro perguntas-chave, exploramos o papel estratégico do digital e os principais desafios que os nossos parceiros anteveem para 2027.
Abrimos esta rubrica com a Guerra e Paz, um cliente que caminha connosco desde 2023 e com quem já desenvolvemos três lojas online de elevado volume de negócios. Fique com a sua visão sobre o futuro do digital.
Guerra e Paz
A Guerra e Paz é uma editora generalista sediada em Lisboa, fundada a 10 de abril de 2006, com um lema que serve de programa: «é preciso virar a página». O catálogo atravessa os clássicos — de Eça de Queirós a Machado de Assis, de Padre António Vieira a Mark Twain —, as novas edições de Jorge de Sena, o ensaio da coleção Os Livros Não se Rendem e os livros de arte da Três Sinais. Faz livros em papel, com grafismo ousado e materiais por vezes improváveis, e vende também pela sua loja online.
O Grupo Guerra e Paz Gradiva é composto por duas casas editoriais independentes; a Guerra e Paz com 20 anos e a Gradiva já conta com 45 anos. O catálogo é vasto e generalista: desde a colecção de Ciência Aberta que trouxe nomes para Portugal como Hawking e Sagan, a as coleçções de Clássicos e Atlas Históricos que não param de crescer, a ficção literária com o Prémio Nobel da Literatura Ishiguro e outros grandes nomes como McEwan e Eco. O Grupo ainda é composto por três chancelas comerciais: Euforia, Alquimia e Crisântemo.
Rita Fonseca
A Rita Fonseca, editora do grupo Guerra e Paz (Gradiva, Euforia e Alquimia), trabalha num catálogo diversificado que atravessa diferentes géneros e públicos, da literatura generalista ao romance, new adult, dark romance e dark romantasy. É responsável pela chancela Euforia e pela nova Alquimia, dedicada à dark romantasy e à distopia.
Qual é o papel do digital na empresa hoje — ferramenta de vendas, de operação, ou as duas coisas?
Absolutamente essencial para qualquer empresa moderna: toda a nossa operação assenta em boas práticas digitais. Apesar de sermos uma editora e do nosso produto ser — e esperamos que no futuro continue assim! — em papel, é impossível que os processos, a comunicação e a logística não sejam digitais. O uso do digital na comunicação com o cliente, bem como a venda online, também são essenciais. Consideramos excelente termos uma proximidade cada vez maior com o cliente.
Quais são os maiores desafios para 2027?
Para o nosso setor será mantermos os canais de livraria saudáveis. É verdade que com o crescimento do online também houve um crescimento de leitores, mas, infelizmente, ao mesmo tempo houve algum abandono da livraria. A visita espontânea, o espreitar das novidades, o pedido de conselho ao livreiro… Enquanto editora, consideramos que as livrarias físicas são a base da nossa operação e temos de as manter vivas, com inovação, com criatividade, e torná-las mais apelativas.
O que fazem hoje que era impensável há cinco anos?
Contratos assinados digitalmente… o problema é passar tudo o que estava em papel para o digital! Mas, na verdade, todas as operações — revisão, provas da gráfica, etc. — serem digitais e não existir praticamente trabalho em papel.
Se tivessem de apostar num investimento digital para o próximo ano, qual era e porquê?
Abrir mais canais de comunicação digitais com os nossos clientes, fora das redes sociais. Pode ser que a Make It Digital nos ajude com este empreendimento 😉
A conversa fica assim, com um convite em aberto: o canal que a editora quer abrir a seguir ainda não existe. É uma posição invulgar e honesta — a maior parte das empresas procura um canal novo sem saber o que lhe falta, e acaba a duplicar o que já tem. Quando o ponto de partida é «fora das redes sociais», a pergunta seguinte é sempre a mesma: que relação se quer construir, com que frequência, e com que consentimento. Sobre o que está em jogo nessa decisão, já escrevemos em newsletter com subscritores que não vendem nada.
O mundo das editoras de livros em Portugal tem sido uma experiência muito gira para a Make It Digital. Acompanhar o crescimento destes clientes, participando ativamente nas decisões técnicas que sustentam as decisões estratégicas, é tudo aquilo que a Make It Digital defende e procura construir com os seus clientes.
Parabéns à Guerra e Paz pelo caminho e um agradecimento enorme pela confiança no nosso trabalho.
Aproveitem e comprem cultura nos sites da Guerra e Paz, Gradiva e Euforia Editora. Todos sites construídos ao abrigo desta parceria.

As 72 horas depois da Black Friday: onde se ganha ou se perde o que vendeu
O sábado mais caro do ano
Sábado, 28 de novembro. A Black Friday acabou há doze horas. A equipa está de rastos, o dashboard mostra um número bonito, e a decisão mais comum é desligar até segunda-feira. É precisamente aí que se perde uma parte do que se ganhou.
Não porque o cliente desapareça — porque a empresa desaparece. As encomendas de sexta ficam por processar, os emails de confirmação acumulam-se, as primeiras devoluções chegam antes de alguém ter respondido ao primeiro pedido de apoio. E o comprador que gastou 180 € na sexta e não ouve nada no sábado começa a duvidar da compra.
As 72 horas seguintes decidem quanto do pico se transforma em receita e quanto se transforma em estorno, devolução e má reputação. Isto é um plano para essas 72 horas.
Primeiras 24 horas: cumprir o que foi prometido
A prioridade não é vender mais. É não falhar no que já foi vendido.
- Stock real, não stock de sistema. O erro clássico de Black Friday: vender o que já não existe porque a sincronização com o armazém corre de hora a hora. Nas primeiras 24 horas, confirme fisicamente os artigos com mais saída. Uma rotura descoberta na terça é uma devolução; descoberta no sábado é uma substituição que ainda salva a venda.
- Envio e tracking no mesmo dia. Não é preciso entregar — é preciso dizer que está a caminho. Um email com número de seguimento no sábado reduz drasticamente os contactos de apoio de segunda e terça.
- Reforçar o apoio, não o marketing. Se há orçamento para uma coisa neste fim de semana, é para responder a emails. Cada hora sem resposta num pós-compra é uma probabilidade maior de disputa no cartão.
Isto liga-se diretamente ao que já escrevemos sobre entregabilidade de email: um email de confirmação que cai em spam no sábado é indistinguível, para o cliente, de uma encomenda que não existe.
Horas 24 a 48: as devoluções começam a chegar
A primeira devolução chega muitas vezes antes do primeiro elogio. E é normal — nas campanhas de desconto, a taxa de devolução sobe, porque se compra mais por impulso e com menos informação.
O que distingue as empresas que sobrevivem às devoluções de dezembro:
- Processo visível. Uma página clara com prazo, condições e como devolver. Cada dúvida respondida com um email reduz o volume de contactos.
- Reembolso rápido é mais barato do que reembolso contestado. Um reembolso em 48 horas custa menos do que uma disputa de cartão: além do valor, há a taxa de chargeback e o impacto na conta de gateway.
- Troca antes de reembolso. Oferecer tamanho ou variante equivalente antes de devolver o dinheiro recupera parte da venda. Funciona particularmente bem em moda e em artigos com margem alta.
Este ponto tem um lado técnico que não se vê: se o volume de devoluções e reembolsos processados manualmente for grande, o backoffice transforma-se no gargalo de dezembro. Vale a pena medir quantas devoluções por hora a equipa consegue tratar — e comparar com o que a campanha gerou.
Horas 48 a 72: a segunda compra
Chega o domingo, depois o Cyber Monday. A maior parte das empresas trata este momento como uma campanha nova, para o mesmo público. É um erro: quem comprou na sexta é o público mais barato que vai existir em dezembro.
- Sequência pós-compra. Confirmação, envio, entrega e — cinco a sete dias depois — uma mensagem que não vende nada: como usar, garantia, apoio. Só depois a oferta complementar.
- Complemento, não repetição. Quem comprou o casaco não precisa de outro casaco. Precisa das luvas. A oferta cruzada converte muito melhor do que o mesmo desconto em cima do mesmo produto.
- Segmentar quem não comprou. Carrinho abandonado na sexta, visita sem compra, e a lista que abriu o email e não clicou. Cada um merece uma mensagem diferente — e a mensagem de Cyber Monday deve ser a última tentativa, não a primeira.
É aqui que a lista de email se prova. Se a newsletter foi construída com consentimento e segmentação, este é o momento em que paga; se foi comprada ou nunca segmentada, o resultado é uma taxa de spam que contamina os envios de dezembro. Já tratámos disso em newsletter com subscritores que não vendem nada.
O CPM não volta ao normal a 1 de dezembro
Há uma expectativa que se repete todos os anos: «a partir de segunda, os custos acalmam». Não acalmam. O que acontece é uma descida gradual até meados de dezembro, seguida de um novo pico na semana antes do Natal, quando os compradores de última hora aceitam pagar mais por anúncios.
Consequências práticas para a primeira semana de dezembro:
- Não desligar tudo a 28 de novembro. Desligar e voltar a ligar reinicia o aprendizado das campanhas — e paga-se esse reinício em CPM, precisamente na semana em que os custos ainda estão altos.
- Reduzir, não cortar. Baixar orçamento nas campanhas de prospeção e manter nas de intenção. É o oposto do que a maioria faz.
- Reaproveitar os criativos que funcionaram. Os anúncios da Black Friday com melhor desempenho servem para dezembro, com outro enquadramento. Produzir tudo de novo em dezembro é gastar duas vezes.
Sobre a subida de custos no pico, e o que fazer com o orçamento, já escrevemos em porque é que o custo por lead sobe nesta altura.
O stock é uma decisão financeira, não logística
Nas 72 horas seguintes há uma tentação: repor stock com pressa para a semana de dezembro. Antes disso, vale a pena responder a três perguntas:
- O que sobrou tem margem? Se o produto vendido com 30% de desconto já estava no limite, repor ao preço de fornecedor de novembro pode transformar dezembro em prejuízo.
- Quanto custa guardar? Armazém, seguro, capital imobilizado. Há artigos que é melhor liquidar em dezembro do que arrastar para janeiro.
- O que a procura diz? As pesquisas internas do site durante a Black Friday são o melhor estudo de mercado do ano — e ficam esquecidas. Vale a pena exportar os termos pesquisados sem resultado: é a lista de produtos que devias ter tido.
O que medir nos 30 dias seguintes
Uma campanha só se avalia quando o ciclo fecha. As métricas de sexta são vaidade; as de dezembro são gestão.
- Taxa de devolução por produto e por canal, comparada com o período normal.
- Receita líquida — bruto menos devoluções, menos descontos, menos custo de envio, menos custo de aquisição.
- Clientes novos que voltaram. Percentagem de compradores de primeira vez que compraram outra vez em 60 dias. É o indicador que diz se a campanha trouxe clientes ou só transações.
- Custo de apoio ao cliente por encomenda — no pico, dispara, e raramente entra no cálculo.
Em resumo
- O sábado seguinte é dia de operação, não de descanso: stock, envio, tracking, apoio.
- Reembolsar depressa é mais barato do que discutir devoluções em dezembro.
- Quem comprou na sexta é o público mais barato de dezembro — vender complemento, não repetição.
- O CPM desce devagar e volta a subir antes do Natal: reduzir, não cortar.
- Repor stock é decisão de margem. As pesquisas sem resultado são o melhor estudo de mercado do ano.
- Avaliar a 30 dias, em receita líquida e clientes que voltaram — não em vendas de sexta.
A Black Friday dura um dia. O que se ganha ou se perde com ela decide-se nas três semanas seguintes, quando quase ninguém está a olhar.
Alguém está a testar cartões no seu checkout — e você só descobre na fatura
Há uma coisa que aprendi a ver nos painéis de lojas online e que quase nunca aparece nos relatórios de marketing: encomendas que existem, mas não são vendas. Pequenos valores, nomes estranhos, emails que parecem gerados por computador, e um número de recusas do gateway de pagamento que na semana anterior era zero. Não é tráfego. Não é uma campanha mal segmentada. É alguém a usar o seu checkout como máquina de validação de cartões roubados.
O card testing é a forma mais barata de abuso a lojas online: o atacante compra uma lista de cartões no mercado negro — milhares, na maioria já mortos — e não sabe quais estão vivos. A solução é experimentá-las. E a forma mais rápida de experimentar um cartão é fazê-lo passar por um checkout verdadeiro, porque o gateway responde em segundos com um «aprovado» ou «recusado». O seu site passa a ser, sem saber, o serviço de validação de outra pessoa.
O ataque não é uma invasão. É uma experiência de compra
O que torna o problema difícil de aceitar: não há ficheiros alterados, nem portas abertas, nem nada de errado com o site. O atacante usa o formulário tal como foi desenhado. Preenche o checkout, submete o pagamento, recebe a resposta, escolhe o cartão seguinte. Se a encomenda passar, ele nem sequer quer o produto — muitas vezes o envio é para um endereço qualquer ou para um ponto de recolha. O objetivo era o teste, não a compra.
Numa loja pequena, cinquenta tentativas passam despercebidas. Numa loja com campanhas ativas em novembro, cinco mil em duas horas parecem «tráfego da Black Friday». É aí que o ataque se esconde: no meio do pico que todos esperavam.
Os sinais que aparecem antes da fatura
- Taxa de recusas a disparar. Se 20% das tentativas de pagamento falham durante uma hora, e o normal é 3%, não é o mercado. É volume artificial.
- Encomendas de valor mínimo. Muitos pedidos do produto mais barato, repetidos em minutos.
- Emails e nomes sem nexo. Padrões aleatórios, domínios descartáveis, nomes de uma palavra.
- Origem concentrada. Muitos pedidos de poucos endereços IP, quase sempre em datacenters (AWS, Hetzner, DigitalOcean) e não em redes móveis portuguesas.
- Velocidade impossível. Um humano demora 40 segundos a preencher um checkout. Um script demora 400 milissegundos. Vários pedidos no mesmo segundo é a assinatura mais óbvia.
- Falhas no 3-D Secure. Se ativou autenticação forte e vê tentativas a morrer nesse passo, alguém está a usar cartões que não são seus.
Porque é que novembro e dezembro são a época alta disto
Há duas razões, e nenhuma tem que ver com o seu negócio. A primeira é que as listas de cartões circulam mais nesta altura: há mais cartões ativos, mais gente a comprar, mais dados capturados em esquemas de phishing sazonais. A segunda é que os atacantes sabem que as lojas estão ocupadas a olhar para as vendas. Uma equipa que está a acompanhar o ROAS às 23h não está a olhar para o rácio de recusas do gateway. O ruído de fundo é maior, a atenção é menor — é a combinação perfeita.
E há um terceiro fator, o mais desconfortável: muitas lojas apertam a segurança em janeiro, depois do susto. Deviam apertá-la antes de precisarem dela.
O custo real não é o dos produtos. É o da conta de gateway
A primeira reação de um cliente é «essas encomendas não são pagas, logo não perco dinheiro». Errado, por três motivos que se somam.
- Taxas por transação recusada. Muitos contratos cobram por tentativa, não por venda. Mil recusas podem ser uma fatura real no fim do mês.
- Chargebacks. Quando os verdadeiros donos dos cartões contestam os débitos, cada contestação tem uma taxa fixa — e, acima de um certo limiar, o processador começa a olhar para si como cliente de risco.
- O risco de perder o direito de aceitar cartões. Um rácio de chargebacks acima de 1% pode levar o processador a retê-lo os fundos ou a encerrar a conta. Sem conta de gateway, uma loja online não vende.
É por isso que este não é um problema «de IT». É um problema de tesouraria com uma causa técnica.
Travar o ataque em duas semanas
A duas semanas da Black Friday, não vale a pena reescrever a loja. Vale a pena fechar as portas que estão a ser usadas. Por ordem de impacto:
- Limite de ritmo no checkout e nos endpoints de pagamento. No nginx, um
limit_reqpor IP nas rotas?wc-ajax=e nas chamadas à API da loja resolve a maior parte. Cinco pedidos por minuto por IP é generoso para um humano e impiedoso para um script. - Bloqueie datacenters, não países. Bloquear Portugal inteiro é absurdo; bloquear ASNs de cloud no checkout apanha a maioria dos bots sem tocar em clientes reais. Se vende só em Portugal, uma regra geográfica no checkout é ainda mais eficaz.
- Autenticação forte no pagamento. O 3-D Secure obrigatório (SCA) transfere a validação para o banco emissor. Reduz conversão em alguns casos — mas uma conversão perdida custa menos do que um processo de chargebacks.
- CAPTCHA invisível no checkout e no login. Não o pesado, que se vê. O que corre em segundo plano e só pede prova quando desconfia.
- Proteja o
wp-login.phpe oxmlrpc.php. O credential stuffing anda de mãos dadas com o card testing: entram por uma conta, testam cartões noutra. Estes são os mesmos princípios que descrevi em segurança para lá do HTTPS, agora aplicados ao momento em que há dinheiro em jogo.
Se ainda não tem nada disto, comece pelo limite de ritmo. É a medida com melhor rácio entre esforço e resultado, e faz-se numa tarde.
Monitorizar vendas, não só o uptime
Um site pode estar de pé e o negócio estar a ser atacado. Isto é a mesma lição que tirei da forma como montamos monitorização de servidores: um HTTP 200 não diz que o negócio funciona. Acrescente duas métricas ao painel e ponha um alerta em cima de cada uma:
- Rácio de recusas de pagamento por hora. Alerta se passar o dobro da média das últimas duas semanas.
- Encomendas por hora, comparadas com o mesmo dia da semana anterior. Um pico não é só bom sinal; um pico com valor médio baixo é sinal de abuso.
Com estes dois números, descobre o problema em vinte minutos — não na fatura do mês seguinte.
Se já está a acontecer
Não desligue o checkout — isso dá a vitória a quem ataca e tira-lhe as vendas boas. Identifique o padrão no access log (IP, user agent, intervalo entre pedidos), bloqueie-o temporariamente, avise o gateway — têm interesse em ajudar antes de os chargebacks chegarem —, anule as encomendas fraudulentas sem capturar fundos e só depois afine as regras permanentes. Nada disto exige guardar dados de cartão — e não guarde. Tokens do gateway, sim; números de cartão no WordPress, nunca.
Em resumo
- O card testing usa o seu checkout como veículo, não como alvo — por isso não aparece em nenhum antivírus.
- O sinal está na taxa de recusas e no valor médio das encomendas, não no uptime.
- Novembro esconde o ataque no ruído do pico; a defesa tem de estar montada antes.
- Limite de ritmo, bloqueio de datacenters no checkout e SCA resolvem a maioria dos casos em dias, não em meses.
- O custo real mede-se em chargebacks e no risco de perder a conta de gateway — não no stock.
A Black Friday dura um fim de semana. As regras que a protegem deviam valer o ano inteiro. Se quer saber como está o seu checkout hoje — e não a 27 de novembro —, é uma conversa de meia hora.
O custo por lead vai subir nas próximas três semanas (e não é a agência que está a falhar)
Há uma conversa que se repete todos os anos por esta altura. O cliente abre o relatório da primeira semana de novembro e o custo por lead passou de 12 € para 18 €. A pergunta vem sempre com o mesmo tom: o que é que se passou? A resposta honesta é que não se passou nada de errado. Passou-se novembro.
Entre o início do mês e o Cyber Monday, o mesmo orçamento compra menos. Não porque a plataforma ficou mais cara por decisão própria, mas porque o número de anunciantes a disputar as mesmas impressões aumenta de forma abrupta — e, com ele, o preço do leilão. Quem já passou por três ou quatro ciclos de Natal sabe disto e planeia em conformidade. Quem está a gerir campanhas há menos tempo tende a reagir mal, e a reação custa mais caro do que o aumento.
Porque é que o custo sobe exatamente agora
- Orçamentos anuais chegam todos ao mesmo tempo. Muitas empresas reservam a maior fatia do investimento para o quarto trimestre. Esses orçamentos entram no leilão na primeira quinzena de novembro, não em janeiro.
- A intenção de compra sobe — mas também sobem os comparadores. Mais gente à procura de «comprar», «preço» e «promoção» significa mais cliques, mas não necessariamente mais conversões. Parte desse tráfego está a comparar, não a decidir.
- Novos anunciantes sem histórico. Contas criadas para a campanha de Natal entram a licitar alto para ganhar tração. Durante duas ou três semanas, pagam o que for preciso. Quem já tem histórico é arrastado nesse movimento.
- Performance Max e campanhas automáticas a alargar. Sem lista de exclusão de marca e sem sinais de conversão bem definidos, o algoritmo tende a ir buscar o tráfego mais fácil — muitas vezes o que já ia converter de qualquer maneira.
O efeito combinado é previsível: em setores competitivos, o custo por lead sobe entre 20% e 40% em novembro, e volta a descer em janeiro. Isto não é uma teoria. É o comportamento do leilão, todos os anos, com pequenas variações.
O erro que estraga o trimestre
Quando o custo por lead sobe, a reação instintiva é cortar o orçamento para «proteger a margem». É compreensível e quase sempre errado.
Cortar o investimento a meio de novembro faz três coisas, todas más. Primeiro, reduz a participação nas impressões exatamente no período em que a intenção de compra está mais alta. Segundo, desestabiliza o aprendizado das campanhas automáticas, que precisam de volume para manter a otimização. Terceiro, e o mais insidioso: o custo por lead não desce na proporção do corte. O que se perde são as impressões mais caras e também as melhores. No fim do mês, gasta-se menos e vende-se muito menos — e a conclusão que fica é que «o digital já não funciona».
O orçamento de novembro não se corta. Ajusta-se.
O que fazer, por ordem de impacto
1. Separar marca de não-marca. É o primeiro corte de análise e o mais revelador. Se o custo por lead agregado subiu 30% mas o não-marca subiu 60%, o problema está na disputa por termos genéricos. Se a marca também subiu, o problema é outro — provavelmente estrutura de campanha ou sinais de conversão mal configurados.
2. Proteger os termos de intenção comercial. «Preço», «orçamento», «onde comprar» e variações com o nome do produto devem ter campanha e orçamento próprios. São os últimos a sacrificar. Os termos de topo de funil — informativos, genéricos, de comparação — são os primeiros a apertar em novembro.
3. Rever as metas automáticas. Um tCPA ou tROAS definido em setembro, com base num custo por lead que já não existe, passa a estrangular a entrega ou a despejar orçamento em tráfego barato e mau. Ajustar a meta à realidade do mês é gestão, não é batota. O que não se deve fazer é mudar a meta a cada três dias.
4. Negativar o que não se vende. Se não tem promoção de Black Friday, negativar «black friday», «promoções», «grátis» e «desconto» evita pagar por cliques de quem procura outra coisa. Parece óbvio. Todos os anos encontro contas a pagar por esses termos sem qualquer correspondência na oferta.
5. Medir qualidade, não só custo. O custo por lead é um indicador de eficiência, não de resultado. Um lead a 18 € que fecha vale mais do que três a 9 € que não fecham. Se a única métrica que sobe para a reunião é o custo por lead, a decisão de novembro será tomada com a informação errada. Já escrevemos sobre isto em detalhe — o custo por lead isolado engana — e novembro é o mês em que o engano custa mais.
Um exemplo com números
Uma empresa de serviços B2B investia 6.000 € por mês e recebia 500 leads a 12 €. Em novembro, o mesmo investimento trouxe 400 leads a 15 €. A leitura preguiçosa é «a campanha piorou». A leitura correta é: o mercado ficou 25% mais caro e a conta manteve o volume de investimento.
Com os mesmos 6.000 €, há duas decisões possíveis. Cortar para 4.500 € para «manter o custo por lead» devolve provavelmente 280 leads — menos volume, mesmo custo unitário. Manter os 6.000 € e apertar a segmentação devolve 380 leads mais qualificados, com custo unitário semelhante ao do mercado. A segunda opção vende mais. A primeira parece mais arrumada no relatório.
Checklist para esta semana
- Comparar o custo por lead de outubro com a primeira semana de novembro, separando marca de não-marca.
- Confirmar que os termos de intenção comercial têm campanha e orçamento próprios.
- Rever tCPA/tROAS à luz do custo real deste mês — uma vez, com critério, não todos os dias.
- Adicionar negativas sazonais que não correspondam à oferta.
- Definir já o critério de avaliação de dezembro: volume de leads qualificados e taxa de fecho, não custo por lead.
Novembro não é o mês para provar que a estratégia estava certa. É o mês para não a desmanchar por causa de um número que sobe sempre. O custo por lead vai descer em janeiro — a carteira de clientes que se conquistou (ou se perdeu) em novembro, não.
Se está a preparar o investimento de 2027 e quer chegar à reunião com números em vez de intuições, vale a pena ler também o artigo sobre como construir um orçamento de marketing defensável. Poupa a discussão de novembro do próximo ano.
O seu site demora 0,8s no meu portátil e 4s no telemóvel do cliente
O meu portátil mente
Abro o site, carrega em menos de um segundo, tudo fluido. Abro o mesmo site no telemóvel do cliente, em 4G, com trinta separadores abertos: quatro segundos, imagens a saltar, o botão a aparecer depois de eu já ter desistido. É o mesmo código, o mesmo servidor, a mesma página. A diferença é o dispositivo.
Quase todos os problemas de performance que nos chegam começam aqui: alguém testou no sítio errado. Um MacBook com fibra e cache quente não é uma amostra — é o melhor caso possível. E otimizar para o melhor caso é a forma mais eficiente de não resolver nada.
Porque é que o mesmo site tem tempos diferentes
Quatro variáveis explicam quase tudo:
- Processador. O JavaScript que corre em 40ms no vosso portátil pode levar 300ms num telemóvel de gama média — e há muito telemóvel de gama média a comprar coisas.
- Rede. Fibra com 20ms de latência não se compara a 4G com 120ms e perda de pacotes.
- Cache. A vossa segunda visita é sempre mais rápida. O cliente faz a primeira.
- Estado do dispositivo. Bateria em modo de poupança reduz a frequência do processador. Não é um detalhe: é metade dos utilizadores.
Nenhuma destas variáveis aparece num teste feito no escritório. Todas aparecem nas métricas reais dos utilizadores.
As três métricas que interessam
Desde 2024, o Google avalia três métricas principais — e uma delas já foi substituída, o que muita gente ainda não atualizou nos relatórios:
- LCP (Largest Contentful Paint) — quanto tempo até o maior elemento visível aparecer. É a sensação de «abriu». Bom: abaixo de 2,5s.
- INP (Interaction to Next Paint) — quanto tempo o site demora a reagir a um clique ou toque. Substituiu o FID. Bom: abaixo de 200ms.
- CLS (Cumulative Layout Shift) — o quanto a página «salta» enquanto carrega. Bom: abaixo de 0,1.
Repare no que isto significa: nenhuma destas métricas é o tempo total de carregamento. Um site pode demorar 6 segundos a terminar e sentir-se rápido, se o conteúdo principal aparecer cedo e nada saltar. E pode demorar 2 segundos e sentir-se péssimo, se o botão só responder ao terceiro clique.
Onde o tempo se perde, por ordem de impacto
Depois de auditar dezenas de sites, a lista repete-se quase sempre pela mesma ordem:
- Imagens. Ficheiros de 4 MB servidos a 400px de largura. É o problema número um, e o mais fácil de resolver: redimensionar, converter para WebP ou AVIF, e servir o tamanho certo por breakpoint.
- JavaScript de terceiros. Chat, pixel, gestor de tags, mapa, slider, pop-up de cookies. Cada um é uma conexão a outro servidor, muitas vezes bloqueante. Um site com sete scripts externos tem sete pontos de falha.
- TTFB. O tempo até o servidor responder à primeira byte. Se for acima de 600ms, nada do que fizer no front-end compensa — o problema está na base de dados, no PHP ou na cache.
- Tipos de letra. Quatro famílias, oito pesos, sem
font-display: swap. O texto fica invisível enquanto a fonte não chega. - CSS e JS bloqueantes no topo. Ficheiros que impedem o browser de desenhar seja o que for até estarem todos descarregados.
Medir no sítio certo
Há duas formas de medir, e não são sinónimo:
Dados de campo (CrUX, Search Console, RUM) — o que os utilizadores reais experienciaram, agregado no percentil 75. É a verdade desconfortável: se 25% dos utilizadores têm LCP acima de 4s, o site é lento, mesmo que o vosso teste diga 0,9s.
Dados de laboratório (Lighthouse, PageSpeed) — útil para diagnosticar causas, inútil para avaliar experiência. Um score de 98 em laboratório com um telemóvel de gama baixa a 2s é uma má nota à espera de acontecer.
Regra prática: decida com os dados de campo, investigue com os de laboratório. E teste sempre com limitação de rede e CPU — o Chrome DevTools faz isso numa caixa de seleção.
O que fazer, por esta ordem
Não comece pelo que dá mais pontos no relatório. Comece pelo que reduz tempo percebido:
- 1. Imagens. Formato moderno, dimensões corretas,
loading="lazy"em tudo o que está abaixo da dobra — mas nunca na imagem principal, que deve carregar com prioridade. - 2. TTFB. Cache de página, opcache afinado, consultas lentas identificadas. Sem isto, o resto é cosmética.
- 3. Terceiros. Apague o que não usa. Carregue o resto depois da interação ou em diferido. Um chat que não é usado por 95% dos visitantes não pode custar 300ms a todos.
- 4. Fontes. Duas famílias no máximo, com
swape pré-carregamento do peso que aparece acima da dobra. - 5. JavaScript. Diferir, dividir, e remover plugins que injetam 200KB para resolver um problema de 5 linhas.
O erro de perseguir o score
O número do Lighthouse é uma média ponderada de auditorias, muitas delas irrelevantes para o negócio. Já vimos sites a subir de 60 para 95 e a converter menos, porque o que se ganhou em pontuação se perdeu em funcionalidade.
O que interessa medir é outra coisa: quantos visitantes abandonam antes de ver o conteúdo, quantos cliques ficam sem resposta, e o que isso custa em receita. A pontuação é um meio; tratá-la como fim é otimizar para o relatório, não para o cliente.
Validar depois do deploy
Uma otimização que não é verificada é uma suposição. Depois de cada alteração:
- Meça o mesmo URL, no mesmo perfil de rede, antes e depois. Sem linha de base, não há prova.
- Confirme que a página principal continua a responder 200 — e que a monitorização continua ativa. Uma otimização que parte o site é pior do que a lentidão. É por isso que monitorizamos os servidores e não apenas os tempos.
- Espere 28 dias antes de concluir algo com dados de campo: o CrUX agrega por janelas longas, e a melhoria demora a aparecer.
O mínimo aceitável
Se quiser uma fasquia concreta para 2026: LCP abaixo de 2,5s no percentil 75 em telemóvel, INP abaixo de 200ms, CLS abaixo de 0,1, e TTFB abaixo de 600ms. Não é perfeição — é o limiar a partir do qual o site deixa de ser a razão pela qual as pessoas desistem.
E há um teste que não precisa de ferramenta nenhuma: peça a alguém com um telemóvel de gama média, numa rede móvel, para comprar ou pedir orçamento. Cronometre. Se desistir antes do fim, o resto é conversa. Este tema liga-se ao que já escrevemos sobre configurações de servidor que protegem o WordPress: performance e segurança começam no mesmo sítio — no que o servidor faz antes de entregar a primeira byte.
Em resumo
- O vosso portátil não é uma amostra. Meça em telemóvel, com rede limitada.
- LCP, INP e CLS — não o tempo total, e já não o FID.
- Imagens e terceiros explicam a maior parte do problema.
- Dados de campo decidem; dados de laboratório diagnosticam.
- Não persiga o score. Persiga o abandono.
A sua newsletter tem 4.000 subscritores e não vende nada
Ter lista não é ter audiência
Todos os meses alguém nos mostra o número com orgulho: «temos quatro mil subscritores». E todos os meses a pergunta seguinte é a mesma: quantos é que abriram o último email? Quantos clicaram? Quantos compraram? Quando a resposta é um encolher de ombros, o número não é uma conquista - é uma ilusão contabilística.
Uma lista de email não vale pelo tamanho. Vale pelo número de pessoas que a abrem porque esperam algo. Tudo o resto é uma base de dados a acumular pó, e a maior parte das vezes a prejudicar a entregabilidade de quem envia.
Os três tipos de subscritor que tem na lista
Antes de escrever mais um email, vale a pena olhar para a lista como ela realmente é. Na prática, há três grupos:
- Quem abre sempre. São poucos - normalmente entre 10% e 25% - e são a razão pela qual a newsletter existe. Escreva para estas pessoas.
- Quem se inscreveu e nunca abriu. Inscreveu-se por um motivo que já esqueceu, ou nunca foi uma pessoa real. Este grupo é o que estraga as métricas e a reputação do domínio.
- Quem já foi cliente. Abre pouco, mas compra. É o grupo mais maltratado de todos, porque recebe o mesmo email genérico de quem nunca ouviu falar de nós.
Tratar estes três grupos da mesma forma é a razão número um pela qual uma newsletter com milhares de subscritores não gera receita.
O problema das aberturas (e porque não deve confiar nelas)
Desde que a Apple passou a pré-carregar imagens no Mail, a métrica de abertura ficou contaminada. Um email aberto por um robô de privacidade conta como abertura. Ou seja: em 2026, a taxa de abertura é um número simpático para apresentar em reuniões e péssimo para tomar decisões.
O que sobra de fiável: cliques, respostas, cancelamentos e receita atribuída. Se o seu relatório mensal só tem aberturas, não tem um relatório.
A frequência certa não existe - a consistência sim
A pergunta «de quanto em quanto tempo devo enviar?» tem uma resposta chata: depende. Mas há uma regra que se aplica sempre - é melhor enviar de mês a mês, sempre, do que enviar três semanas seguidas e desaparecer dois meses.
Quem recebe um email seu de forma irregular não cria hábito. E sem hábito, cada envio é uma interrupção, não uma visita. Se só tem capacidade para uma newsletter por mês, faça uma por mês - com data fixa e a mesma voz. A previsibilidade é o que transforma uma lista em audiência.
O assunto é o produto
Ninguém abre um email por caridade. O assunto é a única coisa que o subscritor vê antes de decidir se aquilo merece trinta segundos da atenção dele. Na prática:
- Concreto antes de criativo. «Como reduzimos o tempo de carregamento de 4,2s para 1,1s» abre mais do que «Novidades excitantes deste mês».
- Sem maiúsculas e sem exclamações. Não é estilo - é filtro anti-spam e é credibilidade.
- Texto de pré-visualização conta. É a segunda frase que se lê. Deixá-la a repetir o assunto é desperdiçar metade do espaço.
- Uma promessa, cumprida no corpo. Assunto que promete mais do que o email entrega gera cancelamentos - e cancelamentos são o único feedback inequívoco que vai receber.
Um email, uma ação
O erro mais comum depois do assunto: pedir tudo ao mesmo tempo. «Leia o artigo, veja o webinar, siga-nos no LinkedIn, peça uma proposta.» Quando tudo é importante, nada é.
Cada envio deve ter um objetivo único e um botão que o concretiza. Se o objetivo é levar pessoas ao artigo, o botão é o artigo. Se é marcar uma chamada, o botão é a chamada. Os links secundários podem existir, mas discretos e no fim.
A segmentação mínima que funciona
Não precisa de um sistema de automação com vinte fluxos. Precisa de três segmentos:
- Novos (últimos 90 dias) - quem ainda está a decidir se vale a pena abrir o próximo.
- Ativos (abriram ou clicaram nos últimos 6 meses) - o núcleo da lista.
- Clientes - quem já comprou e deve receber conteúdo diferente, não a mesma isca de entrada.
Com estes três, já consegue deixar de enviar a mesma mensagem a pessoas em momentos completamente diferentes da relação. É a melhoria com melhor retorno por hora de trabalho.
Higiene: apagar é uma boa notícia
Uma lista grande com endereços mortos custa dinheiro e queima reputação. Os fornecedores de email avaliam o comportamento agregado dos envios: se uma fatia grande nunca abre, os envios passam a ser tratados como suspeitos - e isso afeta também quem abre sempre.
Regra prática: quem não abre nem clica há 12 meses entra num fluxo de reactivação de dois emails. Se não responder, sai da lista. Não é perda; é limpeza. Uma lista de 1.200 pessoas atentas vale mais do que 4.000 onde 3.000 são ruído.
Atenção a um detalhe técnico que muita gente ainda ignora: desde 2024, os grandes provedores exigem autenticação (SPF, DKIM e DMARC) e cancelamento com um clique para envios em massa. Sem isto, nem chega à caixa de entrada. Já explicámos como se configura em O formulário funciona. O email nunca chega.
Consentimento não é burocracia, é segmentação
Comprar listas é a forma mais rápida de destruir a entregabilidade de um domínio - e é ilegal em Portugal sem consentimento válido. Mas há uma vantagem prática em fazer isto bem: quem deu consentimento explícito, com duplo opt-in, tem muito mais probabilidade de abrir.
Três coisas que valem sempre a pena: duplo opt-in na inscrição, um rodapé com cancelamento visível e um link para a política de privacidade, e retenção definida - quem não interage há dois anos não deve continuar na base de dados só porque «pode vir a querer».
O relatório que interessa
No fim do mês, quatro números bastam:
- Cliques únicos por envio - o sinal mais honesto de interesse.
- Cancelamentos - mede se a promessa está a ser cumprida.
- Receita atribuída - pedidos, propostas ou vendas que começaram no email.
- Tamanho da lista ativa - não a lista total. Se este número não cresce, o resto é ruído.
Isto liga-se ao que já defendemos sobre decidir o orçamento com números: uma newsletter sem receita atribuída é uma despesa mensal com boa consciência.
Por onde começar esta semana
Não precisa de um plano de doze meses. Precisa de três decisões:
- Definir a data fixa do próximo envio - e não falhar.
- Escolher um único segmento para o próximo email. Não a lista toda.
- Escrever um assunto que diga exatamente o que vai dentro.
Depois envie e olhe para os cliques da primeira hora. É a informação mais útil que vai ter este mês.
Em resumo
- Lista grande não é audiência. Audiência é quem abre porque espera algo.
- Aberturas já não são métrica fiável; cliques e receita são.
- Frequência consistente vale mais do que frequência alta.
- Um email, uma ação.
- Três segmentos resolvem 90% do problema de relevância.
- Apagar subscritores inativos melhora os resultados de quem fica.
Se a sua newsletter tem milhares de subscritores e não vende, o problema quase nunca é o texto. É a lista, a segmentação e a promessa.
Um assistente de IA que corre na sua máquina: o que é o OpenClaw
A pergunta que devia vir antes da subscrição
Todos usamos assistentes de IA. Escrevem um email, resumem um documento, explicam um erro de PHP. O problema começa quando a pergunta deixa de ser genérica: «porque é que o site do cliente caiu ontem às três da manhã?», «qual foi a configuração de nginx que decidimos em setembro?», «faz o deploy e diz-me se o formulário voltou a enviar». Aí o assistente não sabe nada, porque nunca viu nada. O contexto da empresa vive em ficheiros, servidores e decisões — não na conta de outra pessoa.
É esta a diferença que o OpenClaw vem resolver, e é uma diferença de arquitetura, não de modelo.
De responder a fazer
Um chat convencional recebe texto e devolve texto. Um agente recebe um objetivo e tem ferramentas: ler ficheiros, executar comandos, abrir um browser, consultar uma base de dados, enviar uma mensagem. O modelo continua a ser o cérebro, mas passa a ter mãos.
Isso muda tudo — incluindo o risco. Um sistema que só escreve pode estar errado; um sistema que executa pode estar errado e agir. Toda a arquitetura de um agente sério é, por isso, metade capacidade e metade travão. Voltamos a isto mais à frente, porque é a parte que quase ninguém mostra numa demonstração.
O que é o OpenClaw
O OpenClaw é um gateway de agente que corre na máquina de quem o usa — o portátil, um servidor próprio, um VPS. É open source, funciona com vários fornecedores de modelos (e com modelos locais), e liga-se aos canais onde a conversa já acontece: WebChat, Telegram, Discord, WhatsApp, Slack, Signal, entre outros.
Na prática, isto significa uma coisa simples e rara: o mesmo agente, com o mesmo contexto, responde no telemóvel e trabalha no servidor. Não há sincronização a fazer entre dois produtos, porque é o mesmo produto.
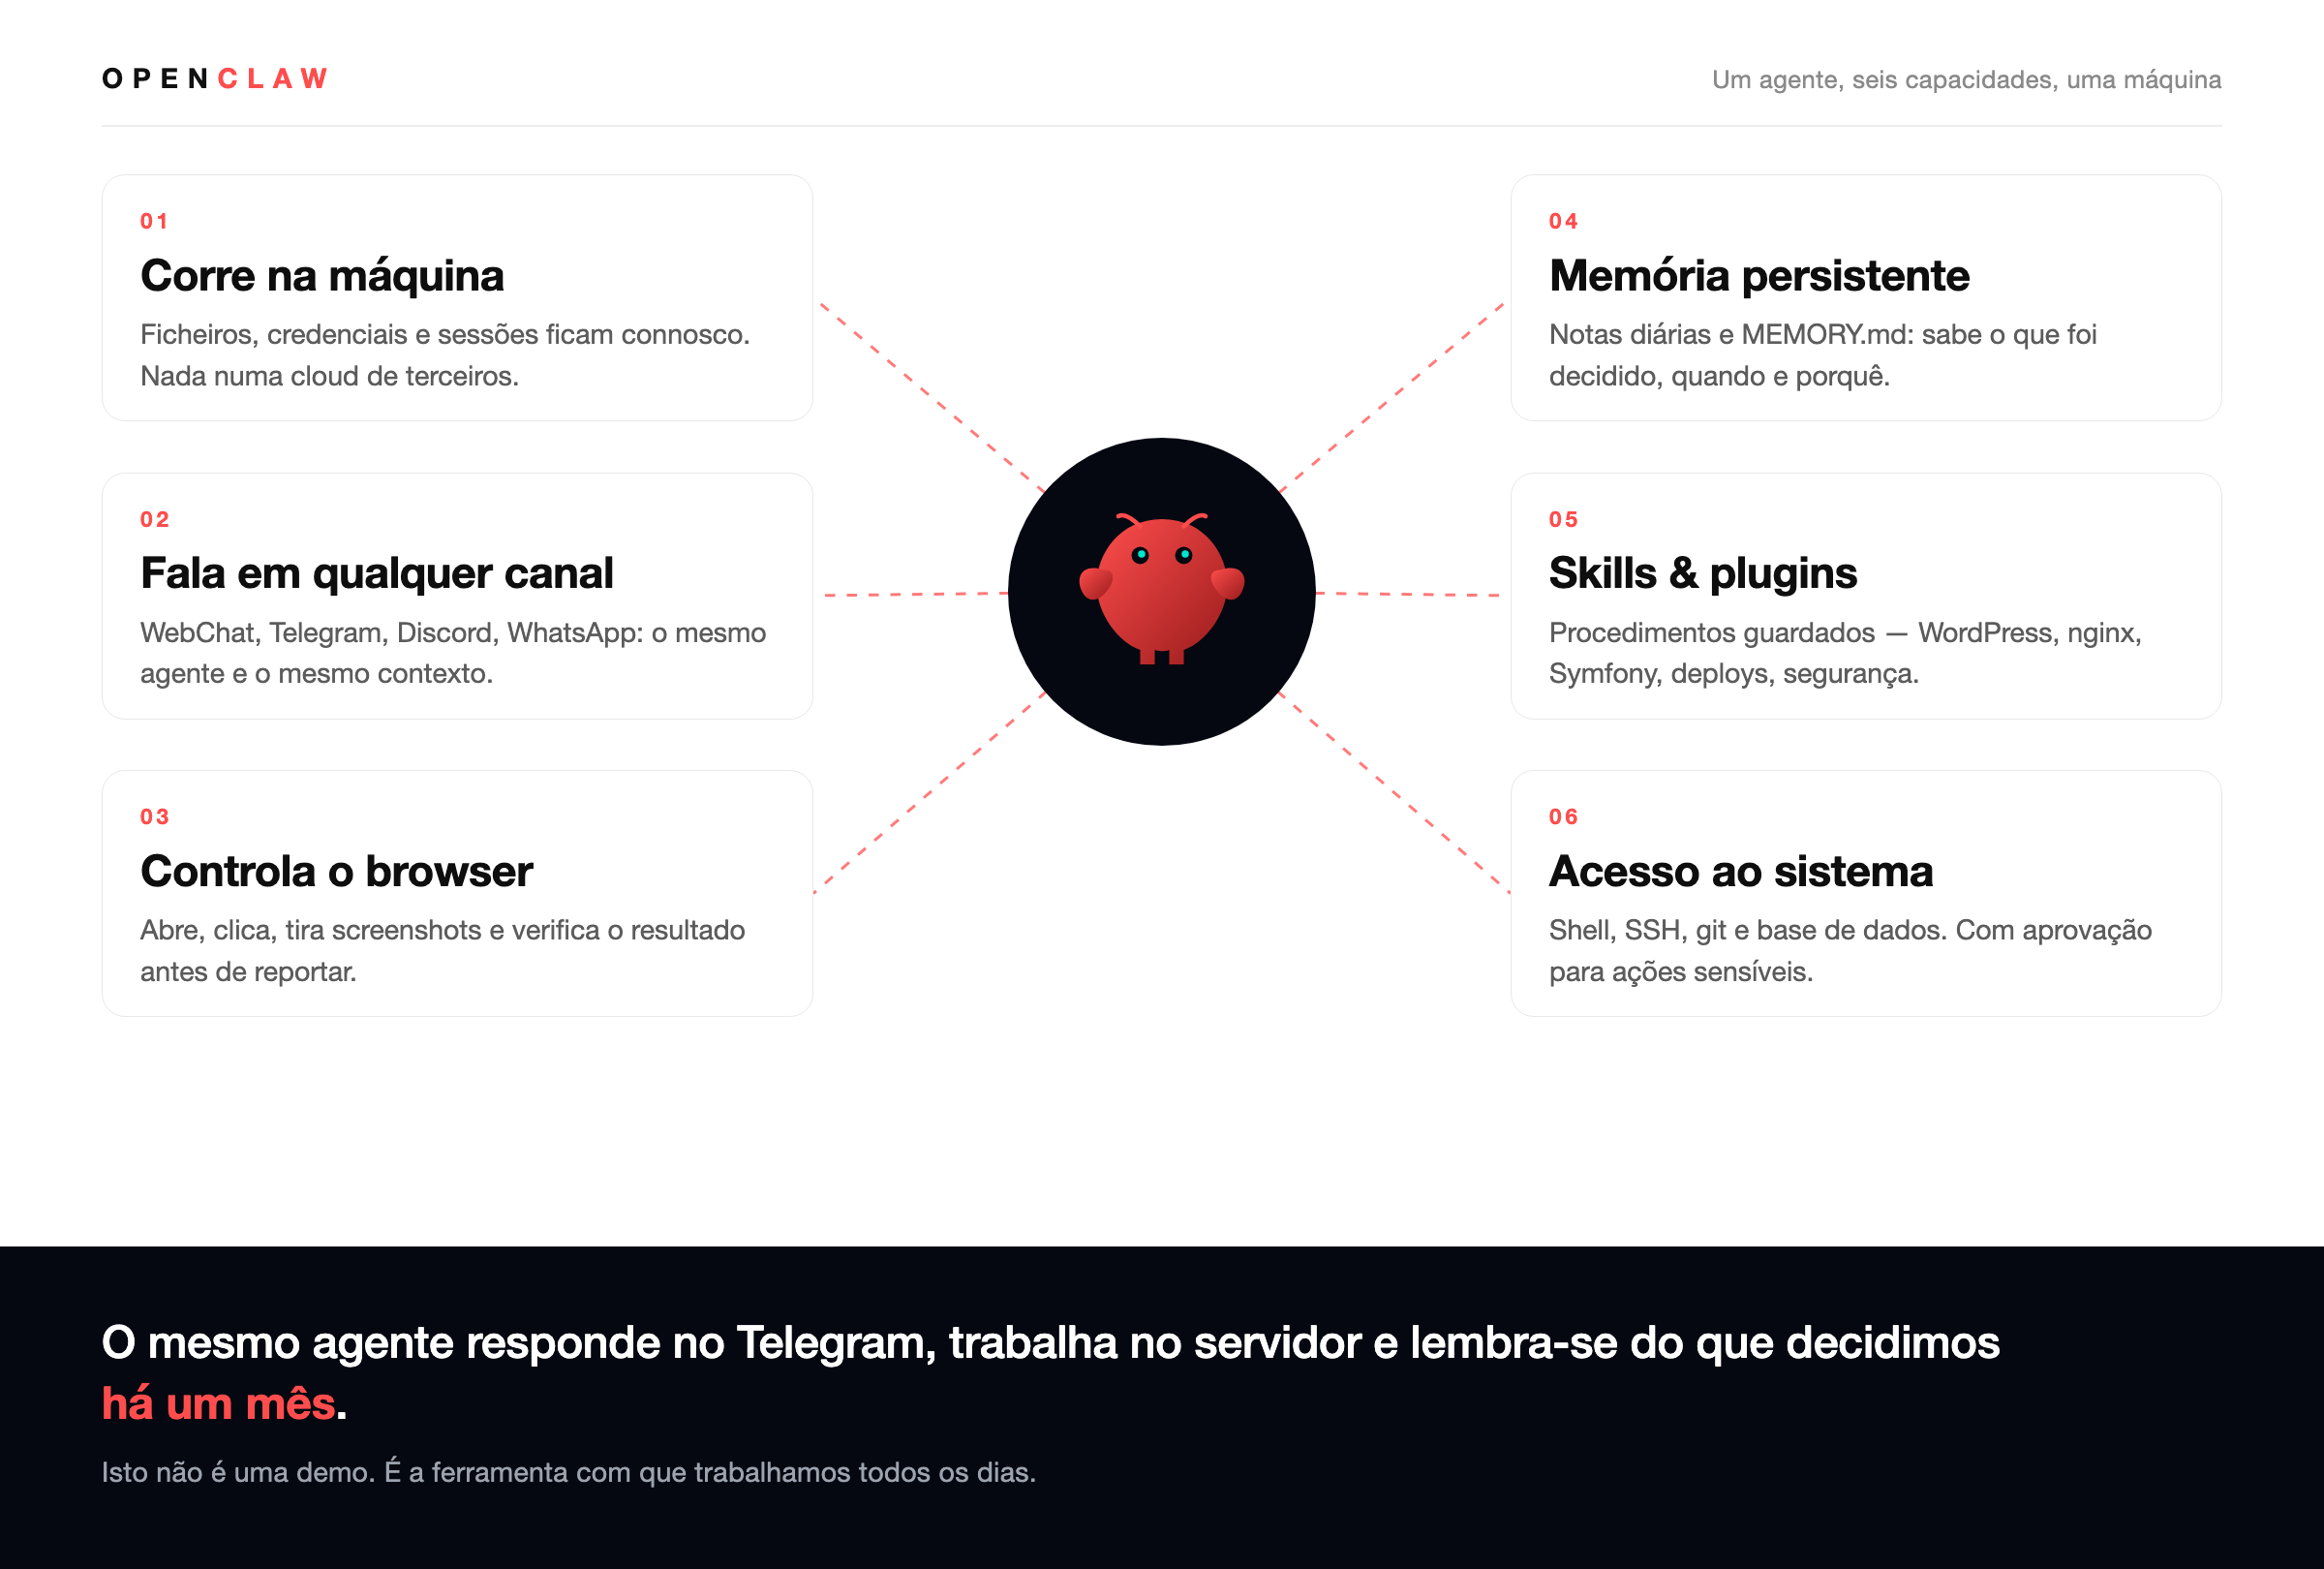
As seis peças, uma a uma
1. Corre na máquina. Ficheiros, credenciais e histórico de sessões ficam onde estão. O modelo é chamado através de uma API, mas o que é enviado é apenas o que a tarefa exige — não um índice da sua empresa. Para quem trabalha com dados de clientes, esta é a diferença entre um sistema que se pode auditar e um que se tem de acreditar.
2. Fala em qualquer canal. O canal é uma entrada, não um produto separado. A conversa que começou no Telegram pode continuar no WebChat sem perder o fio, porque o contexto está no agente e não na aplicação.
3. Controla o browser. Abre páginas, clica, preenche, tira screenshots. E — o detalhe que interessa — verifica o resultado antes de dizer que está feito. Um agente que reporta sucesso sem confirmar é pior do que não ter agente: foi exatamente esse tipo de falha que já nos apareceu em automações antigas.
4. Memória persistente. Notas diárias e um ficheiro de memória de longo prazo. Sabe o que foi decidido, quando e porquê. É a diferença entre um assistente que começa do zero a cada conversa e um colega que se lembra do contexto do projeto.
5. Skills e plugins. Procedimentos guardados em ficheiros de texto: como fazer um deploy de um tema, como diagnosticar um 500 do PHP-FPM, como bloquear execução de PHP em uploads, como rotular um post. Em vez de reaprender a tarefa todas as semanas, o agente lê o procedimento que já funcionou — e corrige-o quando deixa de funcionar.
6. Acesso ao sistema. Shell, SSH, git, base de dados. Com aprovação explícita para ações sensíveis. É a peça mais poderosa e a que exige mais disciplina.
Um dia normal, na prática
Nada disto é abstrato. Num dia de trabalho, o mesmo agente pode:
- Verificar se o último artigo foi publicado, comparando o que o processo diz que fez com o que está mesmo no WordPress — e avisar quando os dois não coincidem.
- Ler os logs de um servidor, identificar o IP que está a martelar o formulário e propor a regra de bloqueio, com o comando exato à espera de aprovação.
- Preparar um rascunho de artigo com links internos já testados, e deixá-lo em draft para revisão humana.
- Correr o deploy de um tema e confirmar, com screenshot, que a página continua a responder 200.
Nenhuma destas tarefas é glamorosa. É precisamente por isso que valem: são as que consomem tempo e as que se esquecem quando o dia aperta.
O que impede o desastre
Um agente com acesso a shell é, literalmente, um utilizador com acesso a shell. A conversa sobre segurança não é opcional — é o núcleo do desenho.
- Aprovação humana para o que destrói. Comandos sensíveis pedem confirmação explícita, com o comando completo à vista. Aprovar não é dizer «sim» a uma intenção; é ver a linha exata que vai correr.
- Privilégio mínimo. O agente não precisa de root para tudo. Contas separadas, chaves separadas, permissões separadas.
- Quarentena em vez de eliminação. Mover para uma pasta isolada é reversível; apagar não é. Um agente bem configurado prefere sempre o gesto reversível.
- Segredos que não passam por chat. Nada de passwords em mensagens ou em argumentos de linha de comandos — ficheiros com permissões restritas e leitura programática.
- Registo. Cada ação fica registada. Sem registo não há auditoria, e sem auditoria não há confiança.
Isto liga-se ao que já escrevemos sobre configurações de servidor que protegem mesmo o WordPress: a maior parte dos incidentes que vimos não nasceu de um ataque sofisticado, nasceu de uma permissão a mais e de um ficheiro a menos.
Os limites honestos
Um artigo que só mostrasse vantagens não era útil. O que é preciso saber antes de experimentar:
- Custa tokens. Cada tarefa consome chamadas ao modelo. Automação contínua tem um custo mensal real, que deve ser comparado com o tempo poupado.
- Não é determinístico. Duas execuções da mesma tarefa podem divergir. Para trabalho repetitivo e verificável, isso é gerível; para decisões reguladas, não.
- É vulnerável a injeção de instruções. Se o agente lê conteúdo da web ou de um email, esse conteúdo pode tentar dar-lhe ordens. A defesa é arquitetural: separar o que é dados do que é instrução, e nunca dar acesso amplo a quem lê fontes não confiáveis.
- Precisa de supervisão. Não é um funcionário; é uma ferramenta com iniciativa limitada. Quem promete autonomia total está a vender risco.
- Não substitui critério. Um agente escreve depressa e verifica mal o que não lhe foi pedido para verificar. A revisão humana continua a ser o último passo.
Aliás, é o mesmo princípio que defendemos para os assistentes que os clientes põem nos sites: âmbito estreito, silêncio nos temas sensíveis e passagem fácil a uma pessoa. Escrevemos sobre isso em o que separa um assistente útil de mais um pop-up.
Porque é que isto nos interessa como agência
Trabalhamos com sites, servidores e prazos. A maior parte do tempo não se perde a decidir — perde-se a executar o que já foi decidido: verificar, repetir, confirmar, documentar. É aí que um agente local compensa.
E há uma razão menos óbvia: sendo open source e correndo na nossa máquina, podemos lê-lo, limitá-lo e explicar o que faz. Não temos de confiar numa caixa fechada para dizer a um cliente onde é que os dados dele passam. Numa conversa sobre RGPD, isso não é um detalhe técnico; é a resposta à pergunta.
Como avaliar em duas semanas
Não comece por «vamos automatizar tudo». Comece por uma tarefa que cumpra três condições: é repetitiva, tem um resultado verificável e o erro é reversível.
- Semana 1. Instalar, ligar um canal, dar acesso só de leitura ao sistema onde a tarefa acontece.
- Semana 2. Correr a tarefa com aprovação em cada passo e medir o tempo gasto, incluindo o tempo de revisão.
Se ao fim de duas semanas o tempo total — execução mais revisão — não for menor do que fazê-lo à mão, o problema é a tarefa escolhida, não a ferramenta. E se for maior, o ganho é real e escalável.
Em resumo
- Assistentes de chat sabem responder. Agentes sabem fazer — e por isso precisam de travões.
- O OpenClaw corre na sua máquina, fala nos canais que já usa e mantém o contexto entre eles.
- Seis capacidades: local, multicanal, browser, memória, skills, acesso ao sistema.
- A parte que importa não é a demonstração; é a aprovação, o privilégio mínimo e o registo.
- Comece por uma tarefa repetitiva, verificável e reversível. Meça o tempo total, revisão incluída.
O resto é entusiasmo. E entusiasmo, em infraestrutura, é a forma mais cara de aprender.
Um chat com IA no seu site: o que separa um assistente útil de mais um pop-up
A pergunta que o formulário nunca responde
Quem chega ao seu site tem quase sempre uma pergunta concreta. «Fazem isto em quanto tempo?», «este livro existe em capa dura?», «o vosso serviço funciona para uma empresa de dez pessoas?». O formulário não responde a nada disto — pede nome e email e promete uma resposta em 24 horas. Entre a pergunta e a resposta há um silêncio onde se perdem contactos que estavam a um passo de acontecer.
Um assistente alimentado pelo conteúdo do próprio site existe para ocupar esse silêncio. Não é magia nem um brinquedo: é a mesma informação que já está publicada, disponível em conversa, à hora a que a pessoa precisa dela.
O que mudou desde os chatbots que todos odiávamos
Os assistentes de 2018 funcionavam por árvores de decisão. Alguém escrevia os percursos possíveis e o visitante tinha de caber num deles. Assim que fazia uma pergunta ligeiramente diferente, o robô repetia «não percebi, escolha uma opção». A fama que os chatbots têm — a de estorvar — vem daí, e é justa.
A geração atual funciona ao contrário. Em vez de programar respostas, dá-se ao sistema o conteúdo que já existe — páginas, artigos, catálogo, perguntas frequentes, documentos de produto — e ele procura os trechos relevantes para cada pergunta antes de responder. Se a resposta não estiver no conteúdo, o comportamento correto é dizer que não sabe e passar a conversa a uma pessoa. Não é o sistema a inventar; é o sistema a encontrar.
Como funciona, sem misticismo
Vale a pena perceber o mecanismo, porque quase todos os problemas de qualidade nascem nele.
- Indexação. O conteúdo é dividido em trechos e convertido em vetores — representações numéricas que permitem comparar significados, não apenas palavras.
- Procura. Quando alguém pergunta, o sistema procura os trechos mais próximos da pergunta. Esta etapa decide tudo: se o texto certo não for encontrado, nenhum modelo, por bom que seja, salva a resposta.
- Resposta. O modelo escreve a resposta a partir dos trechos encontrados, com instruções sobre tom, limites e o que fazer quando não sabe.
Traduzido: a qualidade do assistente é a qualidade da sua documentação. Um site com conteúdo vago produz um assistente vago. Um catálogo bem descrito produz um assistente que responde com precisão.
O que se lhe dá a ler
Esta é a parte que as pessoas subestimam. A base de conhecimento deve incluir o que o cliente pergunta de facto — não o que a empresa gostaria de dizer. Na prática:
- Páginas de serviço e de produto, com prazos, preços e condições reais.
- Perguntas frequentes, mesmo as incómodas: devoluções, prazos de entrega, o que não está incluído.
- Documentos operacionais — garantias, políticas, fichas técnicas.
- Conteúdo editorial que já explica o tema melhor do que qualquer resposta apressada.
E, do outro lado, o que não deve entrar: dados de clientes, informação interna, preços negociados, credenciais. Um assistente é uma superfície pública. Tudo o que lhe der pode ser dito a um estranho.
As três decisões que definem a qualidade
Instalar um assistente destes demora uma tarde. Torná-lo bom demora mais, e resume-se a três decisões.
1. O que pode responder. Um âmbito estreito é uma vantagem. Um assistente que só fala de catálogo, prazos e serviços responde bem. Um que tenta falar de tudo responde mal a tudo.
2. Quando deve calar. Deve haver uma lista explícita de temas em que o assistente não opina — aconselhamento jurídico, fiscal, médico, ou qualquer coisa em que um erro custe dinheiro a alguém. Nesses casos, encaminha.
3. Quando passa a uma pessoa. O handoff tem de ser fácil e registado. Uma conversa que termina em «fale connosco» sem deixar rasto é uma conversa perdida com um custo acrescido: o visitante sentiu que falou com uma máquina e não ficou com nada.
O que fizemos na Penguin Livros
Na Penguin Livros usamos o Chatbase alimentado com o conteúdo do site, e há três detalhes dessa implementação que explicam porque é que o assistente não irrita ninguém:
- Carrega depois da página. O script é injetado no evento de carregamento concluído, não no topo do HTML. Um chat não pode ser a razão pela qual o site demora a aparecer — a velocidade continua a ser o primeiro requisito, como já explicámos ao falar de monitorização e disponibilidade.
- A mensagem de boas-vindas aparece uma vez por dia. Guardada no armazenamento local do browser. Quem já foi cumprimentado hoje não é cumprimentado outra vez — o que parece um detalhe e é a diferença entre um canto discreto e uma janela que salta a cada página.
- Fica desligado durante a madrugada. Entre a 1h e as 8h o comportamento do chat é bloqueado. Se não há ninguém para responder a seguir, um assistente que promete ajuda às 4 da manhã cria uma expectativa que o negócio não cumpre.
Nenhuma destas decisões é tecnológica. São decisões de respeito pelo visitante, e são o que separa um assistente útil de mais um pop-up.
O que isto custa
Estes serviços cobram por conversa ou por mensagem, com um plano base mensal. Para um site com tráfego moderado, o custo é da ordem de uma fração de um salário de apoio ao cliente — mas o número que interessa não é o custo, é o que cada conversa evita ou gera. Duas conversas resolvidas sem intervenção humana pagam o mês. Zero conversas úteis significam que o problema não era o preço.
O que medir, ou não vale a pena ter
Um assistente sem medição é um custo fixo com uma promessa variável. Quatro números bastam:
- Conversas iniciadas. Se ninguém fala com ele, o problema é de visibilidade, não de qualidade.
- Perguntas sem resposta. É a lista mais valiosa que vai ter: cada pergunta não respondida é conteúdo que falta no site.
- Taxa de escalonamento. Muito alta significa que o âmbito é largo demais; muito baixa pode significar que o assistente está a responder a coisas que não devia.
- Contactos gerados. Quantas conversas terminaram em pedido de proposta, orçamento ou compra.
Este último liga-se ao que já defendemos sobre decidir o orçamento com números: sem este, o assistente é uma linha de despesa que ninguém sabe defender.
Quando não vale a pena
Há casos em que a resposta honesta é «não instale isto».
- Pouco tráfego. Com poucas dezenas de visitas por dia, o volume de conversas não paga a configuração nem o tempo de manutenção.
- Conteúdo inexistente. Se o site tem meia dúzia de páginas vagas, o assistente vai expor essa vaguidade em vez de a resolver.
- Assuntos regulados. Onde um conselho errado tem consequências legais, o assistente deve encaminhar sempre — e nesse caso um formulário bem feito chega.
RGPD e o que nunca se cola numa caixa de texto
Um assistente é um tratamento de dados. Antes de o ligar: escolha um fornecedor com contrato de subcontratação, saiba onde ficam os dados e durante quanto tempo, e desative o treino com dados dos seus clientes se essa opção existir. Na configuração, nunca inclua dados pessoais, credenciais ou informação contratual na base de conhecimento. E diga às pessoas, de forma simples, que estão a falar com um assistente — não é obrigatório por lei em todos os casos, é obrigatório por bom senso.
Em resumo
- O formulário não responde a nada. Um assistente alimentado pelo seu conteúdo responde.
- A qualidade vem da documentação, não do modelo. Conteúdo vago, assistente vago.
- Âmbito estreito, silêncio nos temas sensíveis, passagem fácil a humano.
- Carregar depois da página, cumprimentar uma vez por dia e não prometer ajuda a horas em que ninguém a pode dar.
- Medir perguntas sem resposta e contactos gerados — o resto é decoração.
Se quiser saber se isto faz sentido no seu caso, a pergunta certa não é «que ferramenta uso». É: quantas perguntas ficam sem resposta no meu site todas as semanas? Se a resposta for «não sei», comece por aí — e o assistente é o passo seguinte, não o primeiro.
PHP2Shell: a falha que esteve 14 anos no PHP e foi encontrada por uma IA
O código tinha 14 anos. A falha foi encontrada por uma IA em agosto. Só soubemos na terça-feira.
Na terça-feira à noite, sites e serviços começaram a desaparecer. Não por estarem a ser atacados — por precaução. Duas vulnerabilidades críticas no PHP, identificadas como CVE-2026-109618 e CVE-2026-109619 e conhecidas em conjunto como PHP2Shell, obrigaram agências governamentais em vários países europeus a retirar sites do ar enquanto se preparavam as correções.
Ambas têm pontuação de 9,2 em 10 no CVSS v4.0 e permitem execução remota de código sem autenticação. Um atacante não precisa de conta nem de palavra-passe: um único pedido pode correr código no servidor antes de qualquer linha do seu site ser executada.
O que é o PHP e porque isto importa tanto
O PHP é uma linguagem de programação com mais de 30 anos, usada em cerca de 70% dos sites do mundo. WordPress, Drupal, Joomla, Magento e Laravel assentam todos nela. Quando a falha está no PHP, não está num plugin nem num tema: está na fundação que sustenta o site inteiro.
Segundo a PHP Foundation, os problemas estão nas partes do PHP que são acionadas em praticamente todos os pedidos — a gestão de memória e o tratamento de erros. É por isso que a exposição é tão vasta e por isso a correção não podia esperar.
Como funciona a falha
- Corrupção na gestão de memória. Quando um pedido excede o
memory_limit, o PHP aborta-o de forma abrupta. Se isso acontecer a meio da leitura de um upload, a limpeza pode tratar dados inválidos como válidos e libertar memória que nunca foi inicializada — memória que ainda pode conter dados controlados pelo atacante. - Estado obsoleto entre pedidos. Estruturas internas de um pedido podem sobreviver à memória que as suportava. O pedido seguinte, servido pelo mesmo processo, pode usar esse estado antes de a inicialização normal o repor.
São bugs de motor, não de aplicação: não aparecem em testes funcionais, não dão erro e não deixam rasto nos logs. Segundo a NSA norte-americana, o caminho aberto por estas falhas podia chegar diretamente ao sistema de ficheiros ou à base de dados do servidor.
Então porque só se soube agora, se o código tem 14 anos?
Esta é a pergunta que interessa. Os investigadores reportam versões afetadas desde o PHP 5.4 — código de 2012. Durante 14 anos, a falha esteve lá, invisível.
O que mudou foi o método. A PHP Foundation usou um modelo de linguagem de ponta da Anthropic para analisar o próprio código e inscreveu o PHP no programa Patch the Planet, da OpenAI. Foi assim que as falhas foram encontradas — em meados de agosto de 2026 — em simultâneo com a descoberta independente de um investigador. O que durante anos escapou à revisão humana foi identificado por ferramentas que leem código em escala.
A partir daí, a cronologia explica o resto:
- Agosto: falhas descobertas e comunicadas em privado.
- Correção até 22 de outubro: prazo dado aos fabricantes para prepararem pacotes corrigidos antes da divulgação pública.
- 20 de outubro: torna-se pública a falha. As falhas começam a circular em fóruns e redes sociais.
- 21 de outubro, 13:30 UTC: o PHP publica 8.5.12, 8.4.27, 8.3.36 e 8.2.35. O CERT-EU emite o aviso 2026-018 e o CNCS alerta em Portugal.
- 21 e 22 de outubro: agências europeias tiram sites do ar; a Cloudflare confirma os primeiros ataques e ativa regras de firewall.
Ou seja: não estivemos 14 anos sem saber. Estivemos 14 anos sem que ninguém tivesse encontrado. Quando finalmente alguém encontrou, a informação durou dois dias em segredo.
Atualizar o WordPress não resolve
Vale a pena insistir, porque é o erro mais comum. A correção tem de ser aplicada ao nível do servidor: atualizar para PHP 8.5.12, 8.4.27, 8.3.36 ou 8.2.35 e reiniciar o serviço. É a mesma lógica que defendemos em segurança para lá do HTTPS — há camadas que ficam abaixo do site e que o site não consegue proteger sozinho.
E há um detalhe que engana muita gente: os scanners de dependências não detetam esta falha. O Dependabot e o composer audit dizem que está tudo limpo, porque a vulnerabilidade não vive em nenhum pacote que o projeto declare. Um scan verde não significa um servidor seguro.
O nosso dia: esperar, atualizar e validar
Passámos o dia de ontem exatamente nisto. A parte visível foi curta; a parte invisível foi o dia inteiro.
- Inventário. Descobrir a versão real de cada serviço. A versão que o PHP-FPM usa para servir o site não é necessariamente a que responde no terminal — e é a primeira que conta.
- Espera. O anúncio saiu a 20; as correções, a 21 ao início da tarde. Até lá não havia pacote para instalar. Só monitorização, preparação e um plano B escrito.
- Aplicação. Atualizar os pacotes, reiniciar os serviços PHP e confirmar que o processo em execução é o novo, não o antigo ainda em cache.
- Validação. Abrir cada site, testar formulários, lojas e áreas de cliente. Um servidor atualizado que devolve erros 500 não é um servidor seguro — é uma queda de serviço.
É por isso que ninguém deu por nada: quando o trabalho é bem feito, o resultado é exatamente igual ao de antes. A monitorização que temos montada, de que falámos no artigo sobre o UptimeRobot, serve para saber primeiro; este trabalho serve para não precisar de saber.
Os nossos servidores já estão atualizados
Se o seu site é gerido pela Make It Digital, não tem de fazer nada: os servidores que gerimos já estão a correr uma versão corrigida do PHP.
Não foi um clique. Foi uma noitada de trabalho árduo — inventário de cada serviço, atualização dos pacotes, reinício dos processos PHP e validação site a site — feita enquanto as notícias ainda estavam a ser escritas. No fim, tudo de pé: sem uma página em baixo e sem um cliente a notar.
Os nossos clientes podem estar descansados. Quando esta falha chegou às manchetes, o trabalho já estava feito.
O que deve fazer hoje
- Confirme a versão real de PHP que serve o seu site — não a do terminal, a do serviço web.
- Atualize para 8.5.12, 8.4.27, 8.3.36 ou 8.2.35 e reinicie o PHP-FPM.
- Se está em 8.1 ou anterior, migre. O projeto PHP não vai corrigir essas versões; existem apenas correções de código-fonte para 7.4, 8.0 e 8.1, e alguns fornecedores fazem backport.
- Não confie num scan limpo. As ferramentas de análise de dependências não detetam esta falha.
- Valide depois de atualizar. Atualizar sem testar troca um risco de segurança por um problema de disponibilidade.
Em resumo
- Duas falhas críticas no motor do PHP, com execução remota de código sem autenticação.
- O código tinha mais de uma década; o que faltava era alguém — ou algo — que o conseguisse ver.
- A correção é no servidor, não no WordPress.
- Atualizar, reiniciar, validar — e fazer isto antes de haver notícia, não depois.
- Os servidores que gerimos já estão atualizados e validados.
Se não sabe que versão de PHP corre no seu site, essa é a primeira pergunta a responder esta semana.
O orçamento de marketing de 2027 decide-se em novembro. Chegue com números, não com intuições
Em muitas empresas portuguesas, o orçamento de marketing para o ano seguinte é decidido numa reunião de novembro, com uma folha de cálculo aberta e uma pergunta simples: «quanto é que temos para gastar?». É a pergunta errada. A que devia abrir a reunião é outra: «o que é que cada euro nos devolveu este ano?».
Sem essa resposta, o orçamento transforma-se numa negociação de percentagens - mais 10% porque o ano correu bem, menos 15% porque «há que apertar». O problema é que nenhuma das duas decisões tem relação com o que realmente funcionou.
Porque é que o orçamento de 2027 se prepara agora
Outubro é o mês certo para começar. Ainda há tempo para fechar o ano com dados limpos, comparar canais com o mesmo critério e testar uma ou duas hipóteses antes de congelar verbas. Em dezembro, já só se corrigem erros de contabilidade.
Comece por reunir três coisas: o investimento por canal, os resultados atribuídos a cada canal e o valor real de cada lead ou venda. Se o terceiro número não existir, o orçamento vai ser construído sobre areia.
Medir custo por resultado, não custo por canal
É comum ver relatórios que comparam o custo por lead do Google Ads com o custo por clique do Meta, como se fossem a mesma coisa. Não são. O que interessa é quanto custa, em cada canal, trazer um cliente que paga.
- Custo por lead qualificada - não por formulário preenchido.
- Custo por oportunidade - depois de o comercial validar o contacto.
- Custo por cliente - com o ticket médio e o tempo de fecho.
- Receita por euro investido - o único número que sobrevive a uma reunião de administração.
Este exercício muda conversas. Um canal que parece caro por lead pode ser o mais barato por cliente. Outro que enche o formulário pode estar a alimentar o comercial com contactos que nunca vão comprar. Já escrevemos sobre isto em Mais leads ou melhores leads? - e a conclusão mantém-se.
Três perguntas que devem estar na mesa
1. O que é que deixaríamos de fazer se tivéssemos metade do orçamento? A resposta identifica o que é essencial e o que é hábito. Muitas vezes, há verbas que sobrevivem apenas porque ninguém se lembra de as questionar.
2. Onde é que o retorno demora mais de seis meses? SEO, conteúdo e marca são investimentos de prazo longo. Se forem avaliados com a mesma régua das campanhas de resposta direta, vão ser sempre os primeiros a cair - e são precisamente os que sustentam o crescimento seguinte.
3. Quanto é que reservamos para testar? Um orçamento sem margem para experimentação é um orçamento que aposta tudo no que já se sabe. Em 2027, com a pesquisa a mudar de forma e os canais a ficarem mais caros, essa aposta é arriscada. Vale a pena ler o que escrevemos sobre marcas nas respostas da IA.
O erro clássico: cortar no que não se mede
Quando o ano corre mal, corta-se o que é difícil de medir. Branding, conteúdo, relações públicas, comunidade. É um corte fácil de justificar e difícil de contestar. O resultado aparece dois anos depois: menos procura de marca, custo por clique mais alto e uma dependência total de tráfego pago.
A alternativa não é defender tudo. É medir melhor. Se uma ação de marca não tem métricas próprias, crie-as: pesquisa de notoriedade, volume de pesquisa direta, menções, tráfego direto, custo de aquisição ao longo do tempo.
Um exercício simples para novembro
Antes da reunião de orçamento, faça uma tabela com quatro colunas: canal, investimento anual, resultado atribuído e confiança no dado (alta, média, baixa). Depois ordene por resultado e discuta apenas as linhas onde a confiança é baixa. São essas que estão a distorcer a decisão.
O orçamento de 2027 não precisa de ser mais sofisticado. Precisa de ser mais honesto. Se quer chegar a novembro com números que sustentam uma decisão - e não apenas com uma folha de cálculo, fale connosco.